智谱公开国内首个跑进生产环境RSI工程实践成果,让GLM-5.3自己优化自己的运行系统
9月17日,智谱公开了国内大模型厂商首个跑进生产环境的RSI(递归自我改进)工程化实践:由GLM-5.3驱动的Infra Agent,在超10万张国产芯片集群上从零搭建并优化了GLM-5.3-Flash的推理系统,不到两周将端到端吞吐提升至初始基线的3.2倍,硬件利用效率与单Token成本达到主流NVIDIA GPU相当水平。
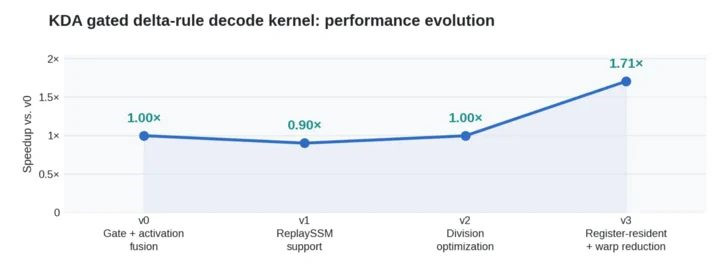
这次实验真正的变化,并不只是让 AI 写代码,而是让 AI 能够理解复杂系统为什么出现性能变化。智谱GLM首席科学家唐杰表示:Infra Agent遇到困难时,很少是因为无法编写代码,而是无法判断为什么结果变差。
例如,当系统反馈“吞吐下降20%”时,它只能说明某个地方出现异常,却无法直接告诉 Agent 哪一层出了问题,当前假设是否错误,以及下一步应该验证什么。对于资深工程师来说,这类判断依赖长期经验。工程师知道什么时候查看执行时间线,什么时候运行微基准测试,以及应该比较哪个模块的输出。智谱团队希望把这种工程经验转化为 AI 可以调用的反馈机制,并将其称为“dense feedback”。
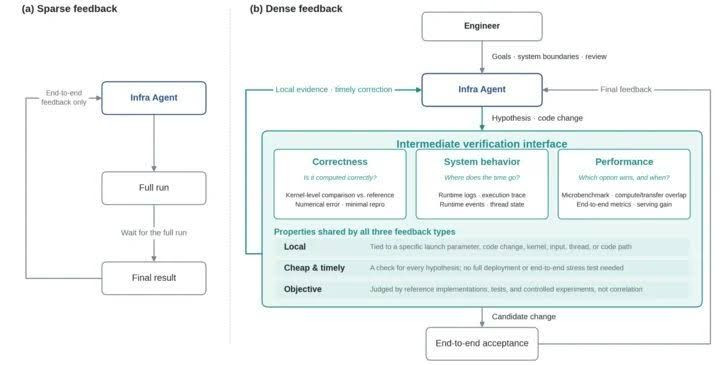
这套机制的核心,是让 Agent 获得更加接近工程判断过程的信息。当模型需要确认计算是否正确时,它可以获得对应的正确性反馈;当模型需要分析性能下降原因时,它可以查看系统运行过程中的时间消耗;当模型尝试新的优化方案时,它可以通过实验判断该方案是否适用于当前场景。
唐杰表示,人类工程师仍然负责设定目标、搭建反馈环境,以及审核高风险修改。但工程师的角色正在变化,从直接解决每一个问题的人,逐渐转向设计反馈系统的人。智谱团队认为,建立在真实基础设施任务上的可验证反馈环境,可能也是训练下一代模型的重要基础。每一次Agent完成工程任务,都可能成为下一代模型学习的数据。目前,GLM-5.3-Flash的案例距离真正意义上的递归自我改进仍然存在距离。但唐杰认为,一个最小规模的循环已经出现:模型优化系统,系统服务模型。
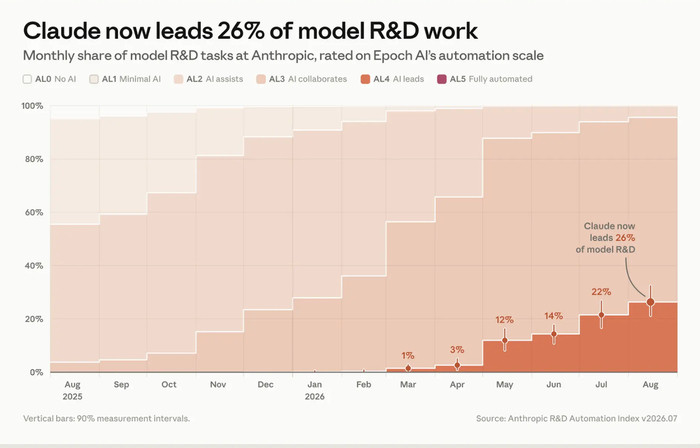
Anthropic9月17日公布的测量结果显示,截至8月,Claude已“主导”26%的AI研发工作,达到或超过“协作”级别的工作占比则在90%以上。与此同时,超过90%的AI研发工作已经至少进入了“AI协作”的阶段。智谱团队也表示,最初团队探索GLM在代码理解和网络安全领域的能力,希望让模型帮助分析复杂代码中的漏洞,但随着模型能力提升,GLM开始参与构建AI系统本身。
过去两年RSI更多出现在论文和创始人访谈里,讲的是用上一代模型来训练下一代模型。但训练只是链条的一端,模型真正要落地,得有推理服务、调度、容错、算子库这些又脏又重的活。智谱的InfraAgent做到了用模型去规划、去排障、去把十万张卡的集群调成能扛流量的状态。对一个常年被质疑国产算力有卡但软件栈跟不上的路线来说,这种模型自己补软件栈短板的路径,比跑分更有说服力。
国内外在RSI这条路上的区别是:海外实验室讲RSI,语境是怕失控、要控制节奏;智谱讲RSI,语境是卡不够、人不够,用模型把产能顶上去。同样是递归自我改进,一边是风险叙事,一边是产能叙事。字节、阿里、腾讯手里都有各自的超大规模集群和各自的模型,但把模型搭推理基建当成标准动作的公司还不多。智谱现在验证了这条路的可行性,把InfraAgent这类实践从炫技项目转成降本KPI是一条能走通的路——既然端到端吞吐能做到基线3.2倍,那就把它和推理成本、交付周期绑在一起考核,让模型搭基建变成一道财务题而非科研题。先把闭环跑通的公司,会在国产算力性价比这个战场上多一张牌。
Anthropic全部AI研发算力中约6%用于安全相关工作。智谱未公布类似比例,但“模型自己搭生产基建”天然带着一个新的安全问题:当模型既能写模型、又能搭运行模型的系统,人类的审查点该放在哪?Dario呼吁的第三方评估者,正好是这个问题的一种解法——让外部的人能摸到内部的数据和系统。国内如果走用模型顶产能的路线,配套的第三方安全评估机制不能缺席,否则产能上去了,信任的缺口也同步扩大。
 xiaohou