英伟达GPU隐藏算力被开源解锁!不改官方驱动,RTX 4090吞吐翻倍
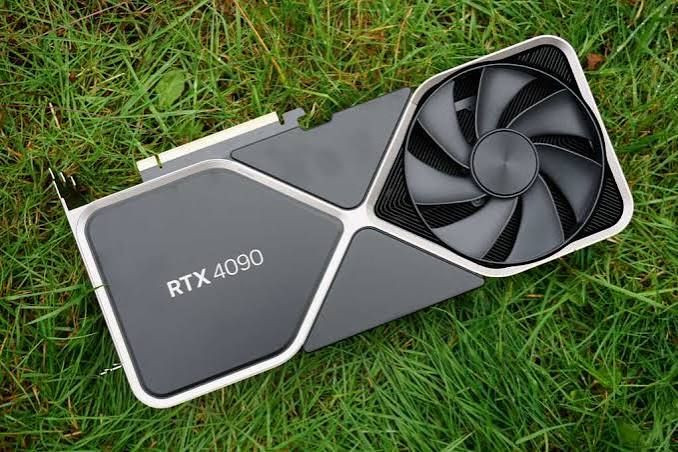
一张 RTX 4090,什么硬件都没换,特定 Tensor Core 运算吞吐率竟然从 165.6 TFLOPS 飙升至 331.6 TFLOPS,直接翻倍!
更让人意外的是,这次被挖出潜力的远不止 RTX 4090。RTX 3090 Ti、RTX 4070 Ti SUPER,甚至 2018 年发布的 RTX 2080 Ti,都在社区测试中取得了显著的性能提升。
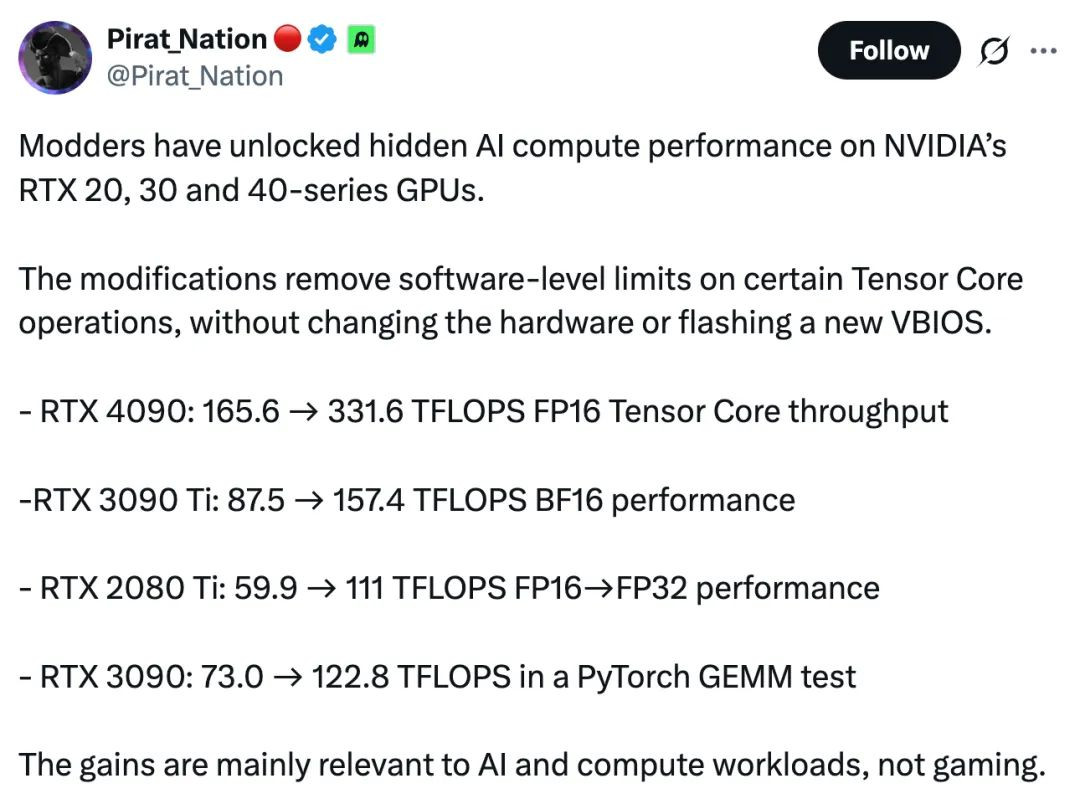
这一切源于 GitHub 上一批开发者对英伟达 GPU 底层计算限制的探索。
他们发现,部分 GeForce 显卡的 Tensor Core 在执行特定混合精度运算时,存在指令发射速率限制。通过修改 GPU 启动阶段的相关配置,可以让原本受限的运算路径恢复更高吞吐率。
不需要更换 GPU,也不用刷写显卡 BIOS。在已验证的 Linux 方案中,原版 NVIDIA 驱动甚至可以照常运行。
目前,针对 RTX 20、30、40 三代显卡的相关项目均已出现在 GitHub 上,部分开发者还在 Windows 11 环境中完成了实验。一场围绕英伟达显卡「隐藏算力」的挖掘,正在开源社区展开。
RTX 4090 算力翻倍
最引人注目的成绩来自 RTX 4090。开发者 JustAResearcher 在开源项目 gpu-unlock-ada 中,展示了 RTX 4090 解锁前后的测试结果。仅仅 2 天时间,该项目已经积累了 2.7k 的 Star 量。
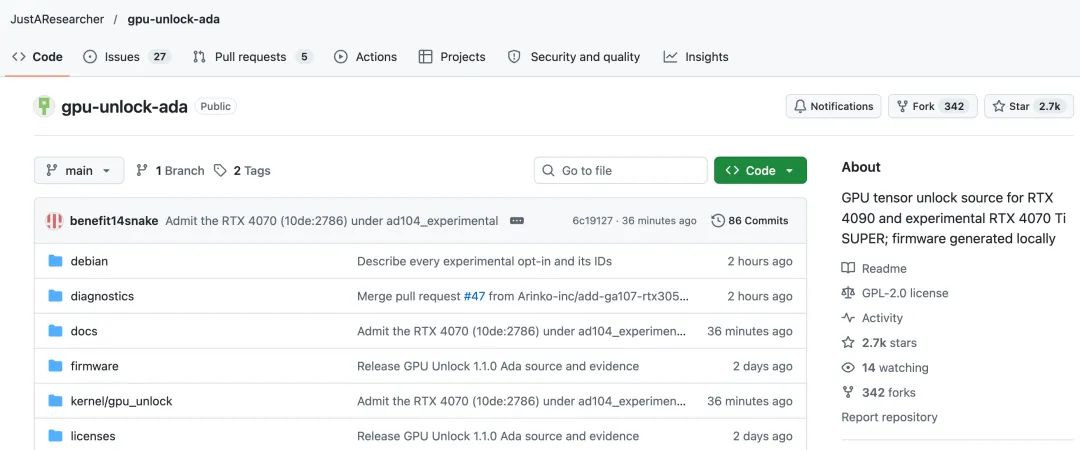
项目地址:https://github.com/JustAResearcher/gpu-unlock-ada
具体来讲,在 FP16 输入、FP32 累加的 Tensor Core 运算中,吞吐率从 165.6 TFLOPS 飙升至 331.6 TFLOPS,几乎翻倍。BF16 输入、FP32 累加的测试也出现了相同的变化,从 165.5 TFLOPS 提升至 330.6 TFLOPS。这意味着,在特定混合精度运算下,同一张 RTX 4090 可以达到此前约两倍的指令吞吐率。
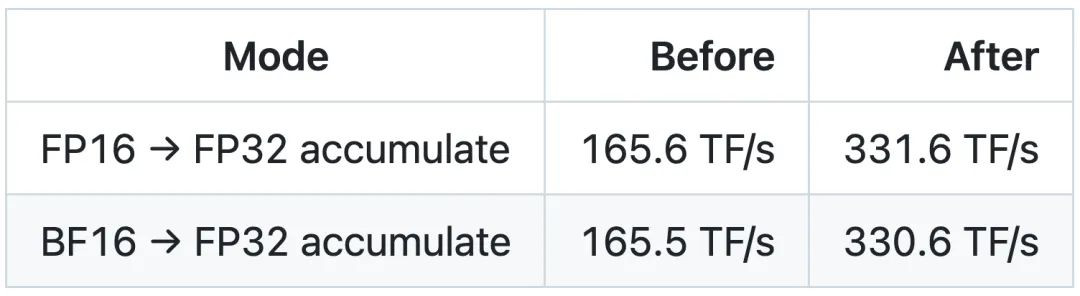
为了排除偶然因素,开发者还将测试循环次数从 2 万次增加到 4 万次,得到的 FP16/FP32 和 BF16/FP32 吞吐率分别为 330.8 TFLOPS 和 330.3 TFLOPS,与之前的结果基本一致。
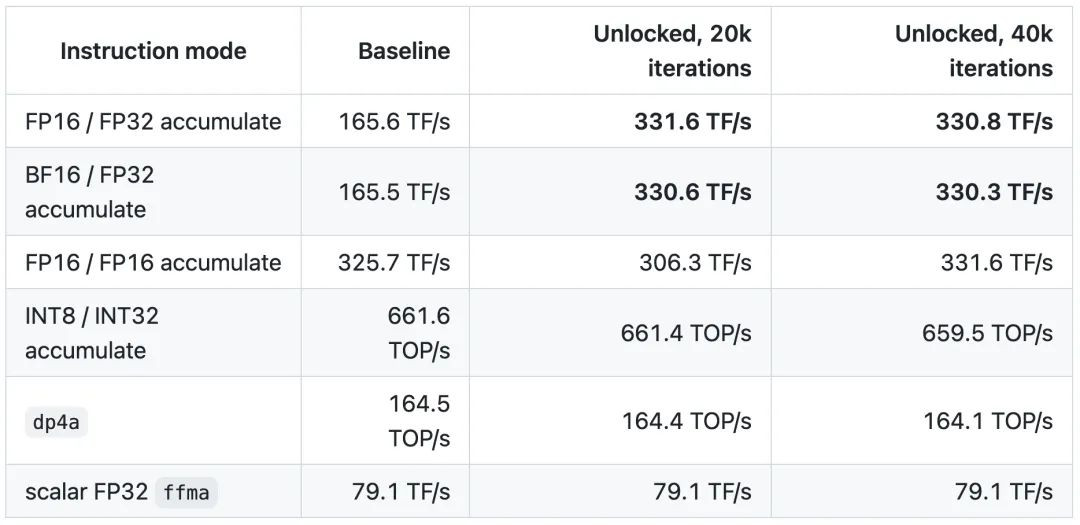
更值得关注的是,整个实验没有更换显卡硬件,也没有通过提高功耗上限、手动超频或者修改 NVIDIA 官方驱动来获得性能提升。
根据技术报告,测试显卡采用 AD102 芯片,拥有 128 个 SM(流式多处理器),运行 Linux 7.2.4 内核,功耗上限保持在 450W。开发者利用 GPU 启动阶段的固件执行流程,打开受保护寄存器的写入权限,随后修改控制计算速率的寄存器配置。
完成配置后,显卡经历了一次 PCIe 功能级重置(FLR),随后由未经修改的 NVIDIA 615.78.08 驱动正常接管。驱动初始化和 CUDA 测试后的寄存器检查表明,解锁配置依然生效。开发者成功解除 RTX 4090 在部分 Tensor Core 运算模式下的速率限制,使原有计算单元在执行 FP16/BF16 输入、FP32 累加指令时达到更高的吞吐率。
不过,性能变化并没有覆盖所有运算类型。例如,FP16 输入、FP16 累加的吞吐率在解锁前就已经达到 325.7 TFLOPS,解锁后经过较长循环测试达到 331.6 TFLOPS,并未出现类似的翻倍。INT8 运算吞吐率基本维持在 661 TOPS 左右,普通 FP32 标量运算也保持在约 79.1 TFLOPS。这说明,此次解锁主要影响此前受到速率限制的特定 Tensor Core 运算路径,并没有让 RTX 4090 的所有计算能力同时翻倍。
同时,另一位 RTX 4090 持有者使用经过审查的项目代码完成了独立复测。这次实验采用 Linux 7.2.11-arch1-1 内核和 NVIDIA 615.78.08 驱动,解锁前后使用同一张显卡、相同的测试程序和 450W 功耗上限,进一步验证了结果。测试显示,FP16 输入、FP32 累加的指令吞吐率从 160.4 TFLOPS 提升至 320.4 TFLOPS,BF16 输入、FP32 累加则从 159.7 TFLOPS 提升至 320.2 TFLOPS,两项结果均接近翻倍。
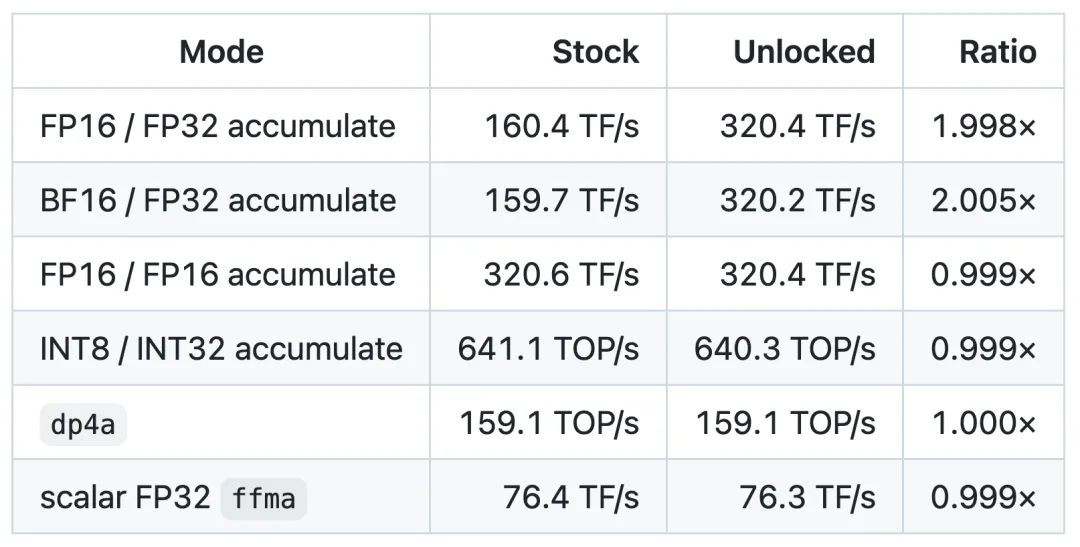
复测地址:https://github.com/JustAResearcher/gpu-unlock-ada/blob/main/docs/evidence/rtx4090-pr1-matched/README.md
但当测试从底层指令吞吐率转向实际矩阵乘法时,性能增幅就没有那么夸张了。在使用 cuBLAS 进行的矩阵乘法测试中,FP16 运算的吞吐率根据矩阵规模不同提升约 12% 至 34%。其中,4096×4096 矩阵乘法的吞吐率从 153.2 TFLOPS 提升至 206.0 TFLOPS,增幅约 34.4%。BF16 的表现则存在更大差异。1024×1024 和 8192×8192 规模的测试分别提升约 19.6% 和 16.0%,但在 4096×4096 的测试中,性能基本没有变化。
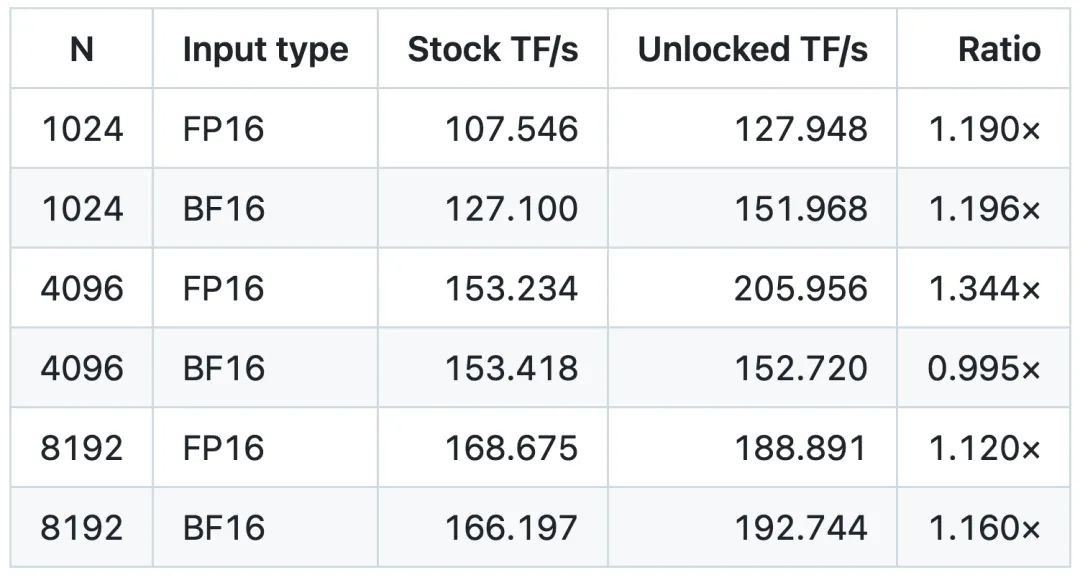
这种差异与实际计算任务的执行方式有关。底层指令吞吐率测试尽量减少了内存访问等因素的影响,而真实矩阵乘法还涉及数据搬运、计算调度以及不同规模下的运算效率。因此,RTX 4090 特定 Tensor Core 指令吞吐率翻倍已经获得了独立复测支持,但这并不意味着实际 AI 训练或推理速度也能翻倍。
RTX 30 系列同样算力暴涨
RTX 30 系列同样传来了好消息。开发者 Zagitta 的开源项目 gpu-unlock,已经在多款 RTX 30 系列显卡上取得了成功。
其中,RTX 3090 Ti 的表现相当亮眼。在 450W 功率上限下,BF16 矩阵运算吞吐率从 87.5 TFLOPS 提升至 157.4 TFLOPS,增幅接近 80%;TF32 的提升更是达到 94%,几乎翻倍。
RTX 3080、3070 和 3060 也陆续传来成功解锁的消息。其中,RTX 3080 10GB 的 BF16 吞吐率从 65.4 TFLOPS 提升至 113.4 TFLOPS,增幅约 73%;RTX 3070 和 RTX 3060 的相关测试也分别取得了约 81% 和 76% 的提升。
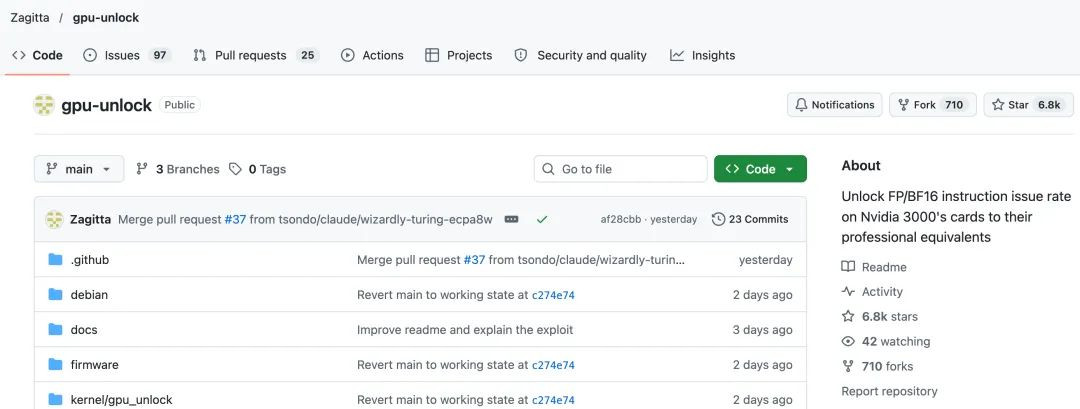
项目地址:https://github.com/Zagitta/gpu-unlock
与之前 RTX 4090 的解锁方案类似,gpu-unlock 同样利用 GPU 启动阶段的固件执行流程,修改控制 Tensor Core 指令发射速率的寄存器配置。
具体来说,NVIDIA GPU 内部存在用于控制不同指令执行速率的寄存器,包括 SS0 和 SS1。这些寄存器受到权限保护,普通驱动无法直接修改。
Zagitta 借鉴了此前 CMP 显卡解锁项目中的 V67 技术,利用 GPU 安全启动固件中的漏洞,通过返回导向编程(ROP)修改权限级别掩码(PLM),从而获得对相关寄存器的写入权限。随后,程序将 SS0 设置为 0*88888888 ,SS1 设置为 0*8,使对应运算路径切换到更高的指令发射速率。
不过,Zagitta 并没有采用修改 NVIDIA 驱动的方式,而是将整个解锁过程整合进了 Linux 内核模块。系统启动时,该模块会在 NVIDIA 官方驱动接管显卡之前运行,完成寄存器配置修改,再通过 PCIe 功能级重置(FLR)使配置生效。随后未经修改的 NVIDIA 驱动便可以正常加载。这套方案可以让部分 Ampere 架构显卡执行 FP16/BF16 输入、FP32 累加指令时,达到原来两倍的指令发射速率。
随着这项技术的传播,越来越多的显卡用户也开始提交独立测试结果。
一位使用 RTX 3080 10GB 的开发者,在 320W 功率上限下进行了进一步测试。除了 BF16 吞吐率提升约 73%,FP16 输入、FP32 累加的矩阵运算吞吐率也从 64.88 TFLOPS 提升至 110.14 TFLOPS,增幅约 70%。
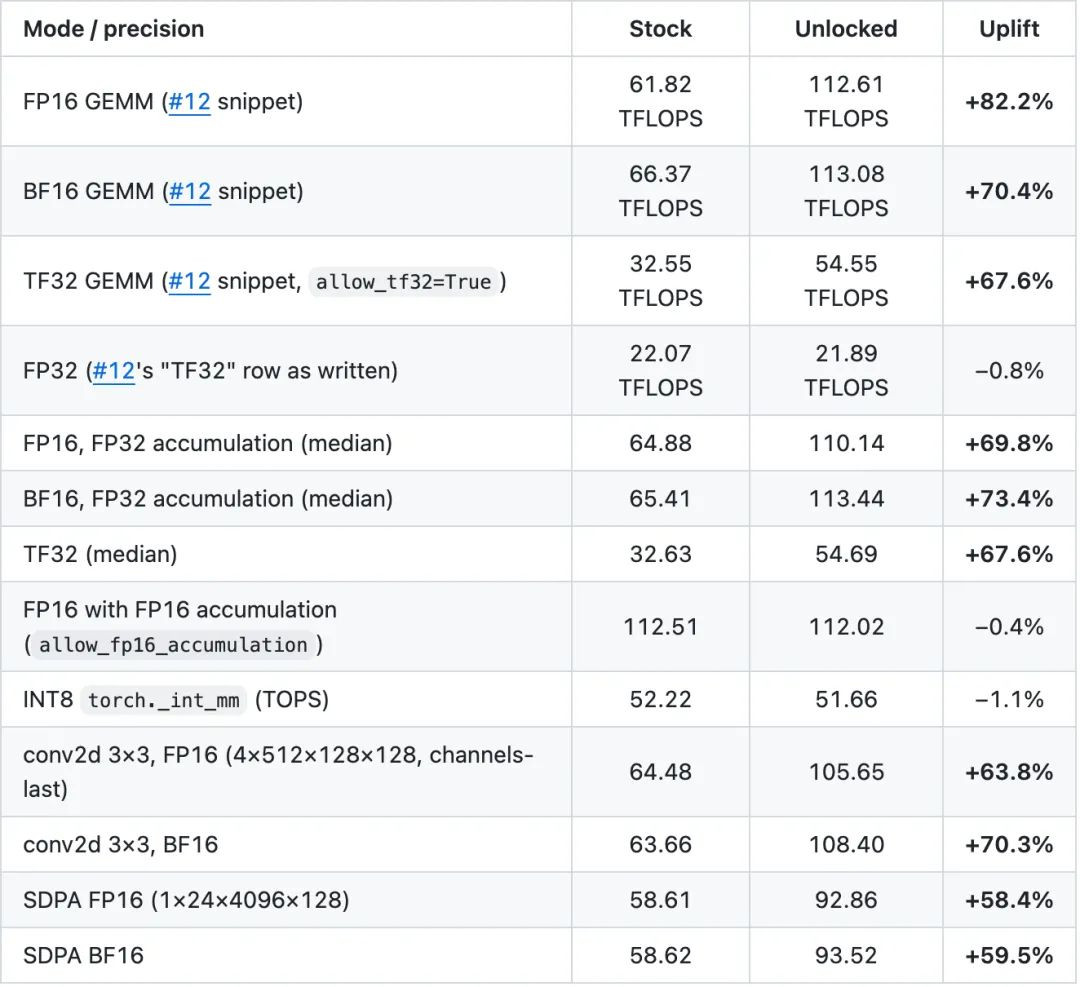
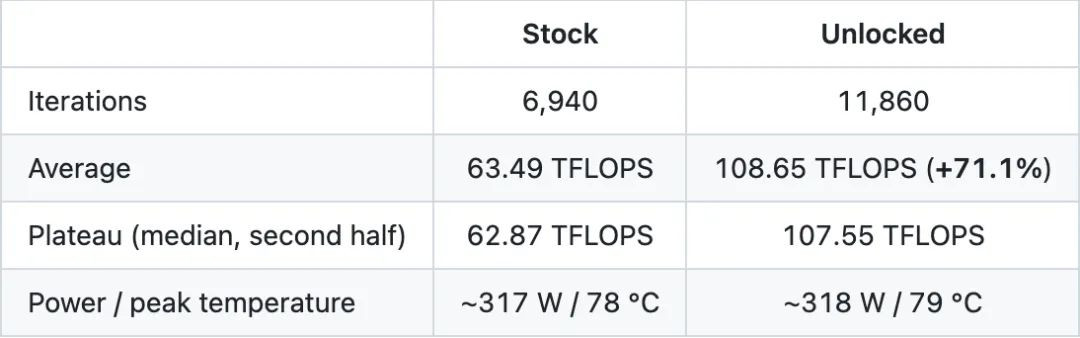
在持续 120 秒的 FP16/BF16 交替矩阵运算测试中,显卡完成的计算次数从 6940 次增加至 11860 次,平均吞吐率提升约 71%。两次测试的功耗均维持在约 318W,峰值温度分别为 78℃ 和 79℃。
测试还验证了计算结果的正确性。在 FP16、BF16 和 TF32 矩阵运算中,解锁前后的输出完全一致。但并不是所有计算任务都会出现类似提升。原本就以较高速率执行的 FP16 输入、FP16 累加运算,吞吐率基本保持在 112 TFLOPS 左右;INT8 运算和普通 FP32 运算也几乎没有变化。
除了矩阵运算测试,部分实际 AI 任务也获得了加速。一位 RTX 3090 用户使用 vLLM 运行 27B BF16 大模型时,发现提示词预填充速度提升约 33%,首个 Token 的响应时间缩短约 24%。另一位使用两张显存扩容版 RTX 3080 的开发者,也在大模型预填充测试中取得了约 33% 至 36% 的性能提升。
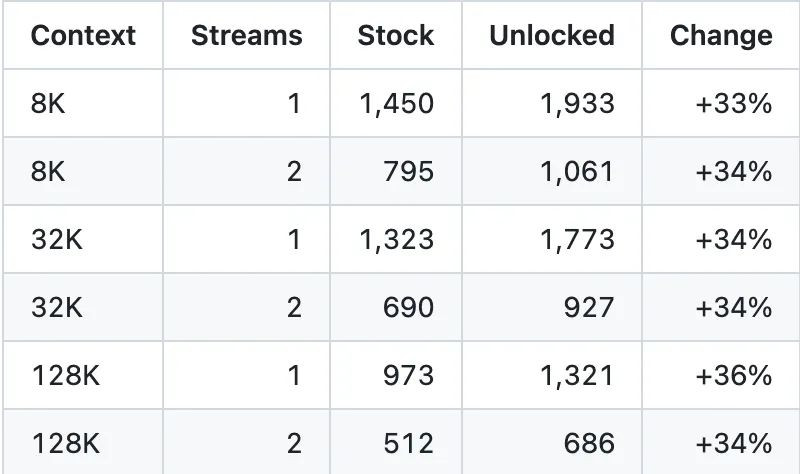
RTX 3080 测试报告:https://github.com/Zagitta/gpu-unlock/issues/15?
不过,两组实验中的逐 Token 生成速度都没有明显变化。这是因为大模型预填充阶段需要进行大量矩阵计算,而逐 Token 生成往往更受显存带宽限制。
从底层寄存器修改到真实 AI 工作负载,这次解锁已经在多款 RTX 30 系列显卡上取得了可观的性能收益。而同样的技术思路,也开始被开发者应用到更早的 GPU 架构上。
8 年前的 2080 Ti 也被挖出潜力
RTX 20 系列的进展则更有意思。2018 年发布的 RTX 2080 Ti,距今已经八年。当年售价上千美元的旗舰显卡,如今早已退出高端 GPU 性能竞争的第一线。但随着 NVIDIA GPU 算力解锁技术的传播,这张老显卡又被开发者重新拿出来测试。
开发者 nlzy 将 gpu-unlock 的相关技术移植到了 NVIDIA Turing 架构,并在 GitHub 上开源了项目 turing-unlock。
项目地址:https://github.com/nlzy/turing-unlock
开发者测试的是一张采用 22GB 非标准显存配置的 Dell RTX 2080 Ti。原版 RTX 2080 Ti 只有 11GB 显存,因此这张测试卡的硬件配置与普通零售版存在区别。在 250W 功耗设置下,开发者使用 cuBLAS 进行了 FP16 输入、FP32 累加的矩阵乘法测试。当矩阵的 M、N、K 三个维度均为 2048 时,吞吐率从解锁前的 55.7 TFLOPS 提升至 91.4 TFLOPS,增幅约 64.1%。
其他矩阵规模也出现了不同程度的提升:
1024:从 50.3 提升至 68.3 TFLOPS,提升约 35.8%;
4096:从 53.7 提升至 81.7 TFLOPS,提升约 52.1%;
8192:从 52.8 提升至 77.9 TFLOPS,提升约 47.5%。
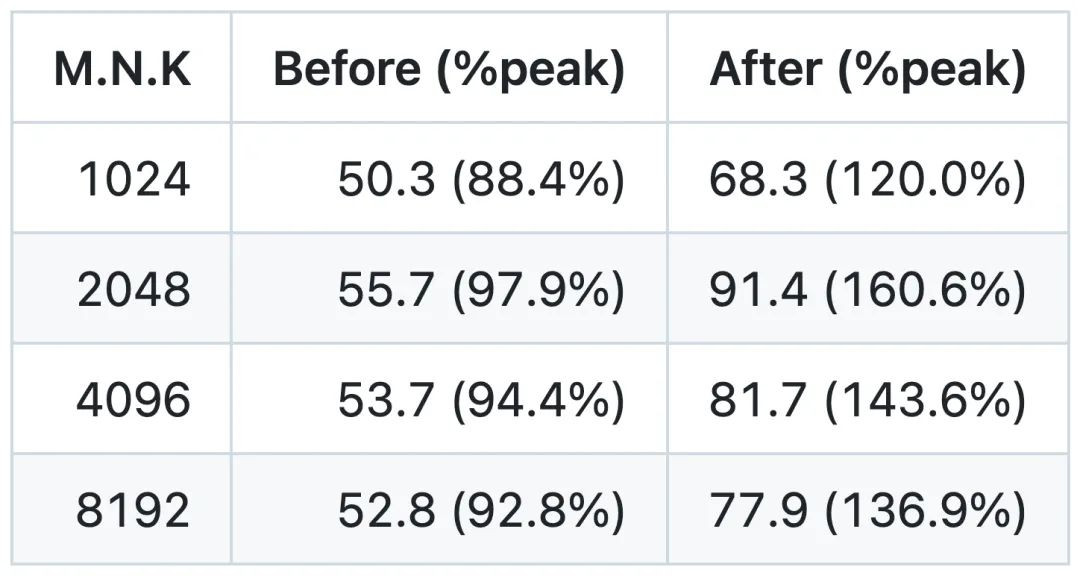
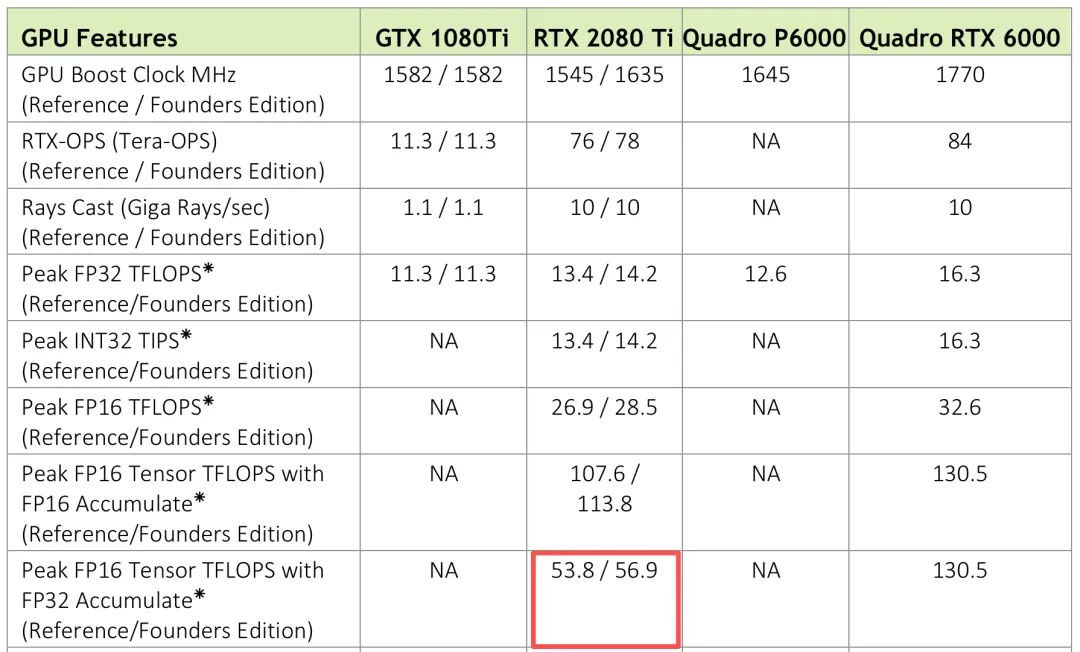
作为对照,NVIDIA 在 Turing 架构白皮书中给出的 RTX 2080 Ti 对应 FP16 Tensor Core 峰值吞吐率为 56.9 TFLOPS。按照这一数字计算,2048 规模下解锁前的测试结果达到了标称峰值的 97.9%,解锁后则达到 160.6%。这说明,原先的速率配置确实限制了这条计算路径能够发挥的吞吐率。调整配置后,原有 Tensor Core 可以在相应运算模式下执行更多计算。
类似的结果也出现在另一名开发者的实验中。
GitHub 用户 haohervchb 发布了单独的 Turing-unlock 研究项目,针对一张 ASUS RTX 2080 Ti 进行了测试。这张显卡采用 TU102 芯片,拥有 68 个 SM,显存容量为标准的 11GB。与 nlzy 的 Linux 内核模块不同,该项目采用系统启动前的 UEFI 执行方案,在操作系统加载之前修改 GPU 的相关配置。
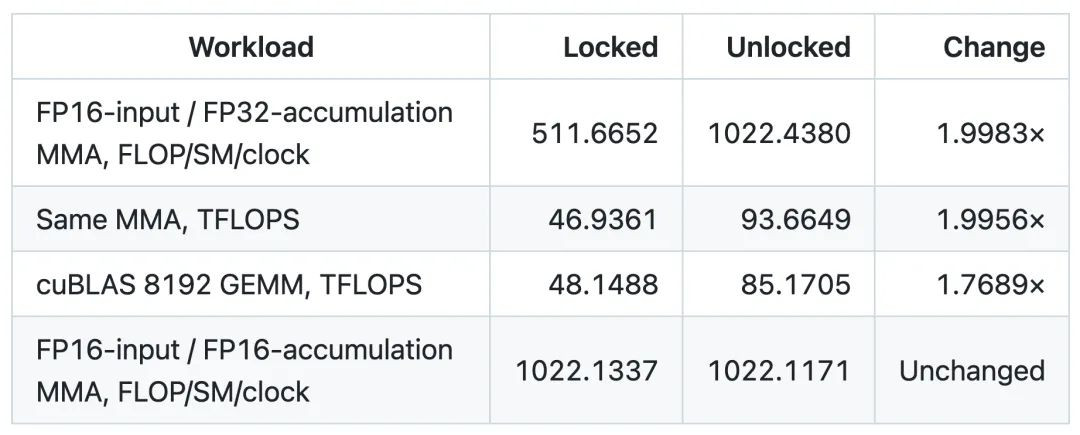
在 FP16 输入、FP32 累加的底层 MMA(矩阵乘加)指令测试中,解锁前的吞吐率为 46.94 TFLOPS,解锁后达到 93.66 TFLOPS,几乎翻了一倍。以每个 SM、每个时钟周期执行的浮点运算次数衡量,性能也从约 511.7 FLOP/SM/clock 提升至 1022.4 FLOP/SM/clock。
项目地址:https://github.com/haohervchb/Turing-unlock
不过换成实际 cuBLAS 矩阵乘法测试后,增幅有所收窄。在 8192×8192 规模的 GEMM 测试中,吞吐率从 48.15 TFLOPS 提升至 85.17 TFLOPS,增幅约 76.9%。虽然没有达到底层指令测试中接近两倍的水平,但对于一张八年前发布的显卡而言,这仍然是相当可观的提升。
目前,两项研究的验证范围仍然有限。现有证据只能说明部分 TU102 显卡能够通过修改速率配置提高特定 Tensor Core 运算的吞吐率。其他 RTX 20 系列型号能否使用相同方法,以及不同驱动、固件版本下的兼容性,都还需要进一步验证。实际 AI 训练、推理和游戏性能能够提升多少,也无法直接用这些测试数据推算。
Windows 11 也有人成功了
以上探索主要集中在 Linux 环境。随着多个项目相继开源,Windows 平台也出现了实验性进展。
开发者 TOTORONG 在 Hugging Face 上公开了 AD103_win_unlocker,展示了在 Windows 11 环境下修改 GPU 计算配置的实验。
项目地址:https://huggingface.co/TOTORONG/AD103_win_unlocker/blob/main/docs/INSTALL.en.md
测试使用的是一张经过显存扩容、容量达到 32GB 的 RTX 4080,采用了 AD103 GPU。
与前面的 Linux 内核模块不同,这套方案使用 UEFI 程序,在 Windows 启动前执行相关配置修改,再将控制权交还 Windows。
项目公布的测试结果显示,在 4096 规模的矩阵乘法中:
FP16/FP32:91.54 → 182.80 TFLOPS。
BF16/FP32:91.91 → 184.49 TFLOPS。
图片
两项测试的吞吐率均接近翻倍。这意味着相关底层配置修改并非只能在 Linux 系统上实现。
但目前的 Windows 11 结果仍来自特定改装显卡,尚不能作为普通 RTX 4080 或整个 RTX 40 系列通用兼容的依据。
 xiaohou