英伟达Vera放弃Chiplet:AI CPU设计转向单核延迟
英伟达Vera CPU团队罕见承认,过去多年数据中心CPU为堆核心数牺牲了单核性能和IPC。Agentic AI的爆发正在逼着这个方向掉头。Vera放弃Chiplet,把88个自研Olympus核心塞回一颗单晶粒上。这件事的分量不在英伟达自己,而在于它可能改写服务器CPU用了近十年的设计公式。
一颗“反潮流”的CPU
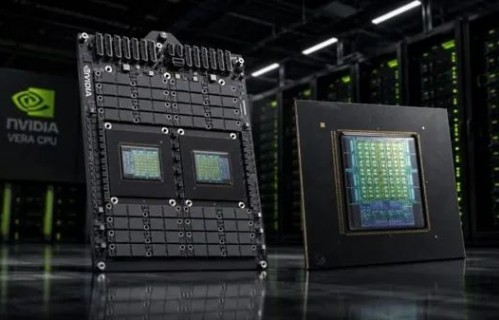
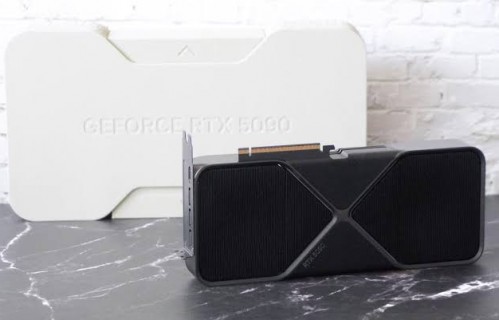
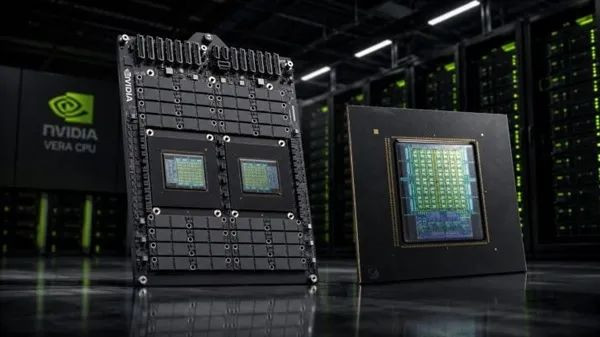
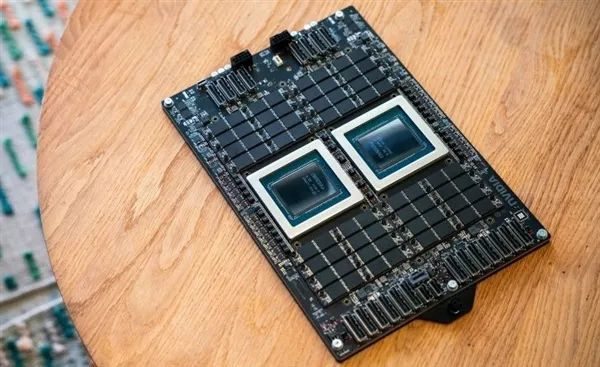
Vera的基本规格不复杂:88个Olympus核心,176线程,LPDDR5X内存,1.2TB/s带宽。真正值得注意的选择是单晶粒,不是Chiplet。
2010年代后期开始,AMD EPYC带头把服务器CPU拆成多个小芯片,核心数从32核一路推到96核、128核,甚至256核。英特尔 Sapphire Rapids也跟进了Chiplet路线。行业默认的逻辑是:云厂商按核心租算力,核心越多越好卖。
英伟达Vera团队在访谈中说得很直白:用Chiplet之后,芯片上没有足够面积给每个核心做性能优化,单线程性能和IPC长期停滞。Vera把88个核心放回一颗die,第二代Scalable Coherency Fabric提供3.4TB/s对内带宽,是可比x86芯片的三倍。
但一个问题随之而来:放弃Chiplet,核心数是不是又不够了?英伟达的答案藏在Agentic AI的工作方式里。
GPU越贵,CPU越不能慢
Agentic AI和传统云端负载有一个根本区别:大量任务必须顺序执行。
一个AI智能体要跑代码、调外部工具、查数据库、分析结果,再决定下一步。有些步骤可以并行,但“决定下一步做什么”这一步只能等前面完成。CPU在这里的角色不是算矩阵,是调度和衔接。它慢一拍,后面昂贵的GPU就多闲置一拍。
英伟达AI基础设施部门在发布Vera时说了一句很直接的话:“AI智能体的速度,取决于驱动它的CPU。”
这解释了一个容易被忽略的账:一台AI服务器里,GPU成本占大头。如果CPU因为单核延迟高,让GPU每天多闲置5%,浪费的钱远高于省一颗CPU的差价。核心数解决的是“同时跑多少任务”,单核性能解决的是“每个任务多快放行” 。Agentic AI把后者的权重拉高了。
那英伟达宣称的性能优势,到底站不站得住?
数据打架,但方向已经清楚
英伟达自报的数据是:Vera单核性能最高达AMD EPYC Venice的1.5倍,智能体编排任务比Sapphire Rapids快约2.2倍。在DeepInfra的生产环境测试中,Vera的runc容器延迟为29ms,Sapphire Rapids为64ms,AMD Zen 5 Turin为35ms。Olympus核心的IPC实测为3.62,高于Sapphire Rapids的2.44。
但AMD随后公布了另一组数字:EPYC 9996在SPECrate 2026整数测试中,单核性能反而是Vera的1.2倍,平台级性能达到2.24倍。双方测试条件并不对等——AMD用的是GCC 16.1编译器,英伟达用的是GCC 15.2,编译器版本差异足以影响跑分。
这是一个反常识的点:在“单核性能”这个英伟达自己选定的战场上,AMD并不认输。 但两家厂商的测试共同指向一个事实:服务器CPU的竞争维度正在从“每瓦每核吞吐量”拆分成“吞吐量”和“每线程延迟”两条线。Vera押的是后者在Agentic AI里的定价权。
市场数据也在配合这个判断。x86服务器CPU份额仍在56%左右,但ARM定制份额已升到37%,英特尔份额被压缩到28%。美国银行预计服务器CPU总市场规模从2026年的610亿美元增长到2030年的2110亿美元,其中约1800亿美元来自AI相关需求。英伟达做Vera,不只是卖CPU,是在AI机架里卡住“系统调度入口”这个位置。
Vera真正的对手不是EPYC 9996,而是“GPU够快、CPU慢一点没关系”这个沿用了十年的采购惯性。 Agentic AI正在让这个惯性变得昂贵。
Vera的考验不在跑分,在机架
Vera的另一个信号容易被忽略:英伟达正在把CPU从“GPU的附属品”变成独立产品线。Grace的定位主要是GPU主机,Vera则被放进独立的CPU机架,专门跑智能体工具调用、代码执行和强化学习环境,最多256颗CPU互联,支持超过2.25万个并发沙箱环境。
这意味着英伟达在AI基础设施里的角色从“卖GPU”延伸到“卖调度层”。如果Agentic AI的负载结构真如英伟达判断的那样向CPU侧倾斜,Vera的成败会直接影响下一轮AI机架的BOM结构:CPU的预算占比会往上走,而GPU的闲置率会成为客户衡量整机效率的新指标。
但变量仍然很多。AMD的256核Venice在平台吞吐量和每瓦性能上守住了自己的阵地,Chiplet路线在超大规模云厂商那里仍有成本优势。Vera能不能把“单核延迟”变成客户愿意单独付费的卖点,2027年的部署数据会给出答案。
你怎么看:你所在的数据中心或AI项目里,GPU的闲置时间有多少是在等CPU?
 xiaohou